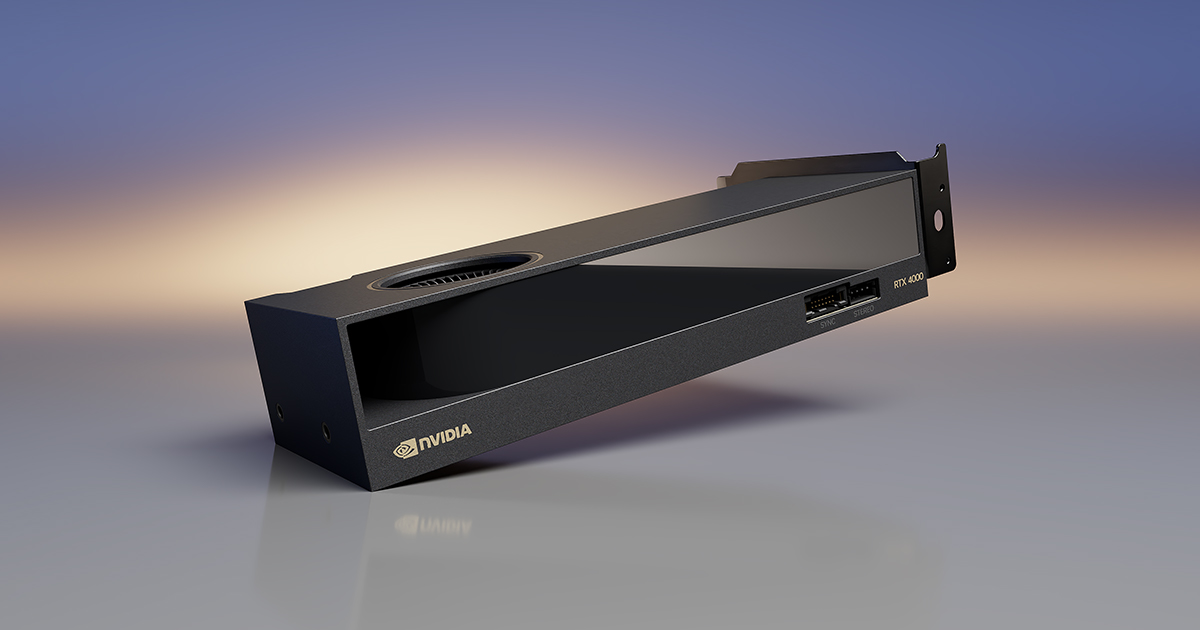
NVIDIA RTX 4000 SFF Ada Generationは20GBのGDDR6メモリを積み、70Wで動く小型GPUです。ローカルLLMでは、モデルのファイル容量をそのままGPUの必要メモリと見なすと選定を誤ります。重みに加え、実行時の作業領域と会話履歴に応じたキャッシュも必要だからです。Ollamaが公開するQwen3の容量を例に、20GBをどう使えるか整理します。
20GBメモリでのモデル選択
OllamaのQwen3一覧は、14Bモデルを9.3GB、30Bモデルを19GB、32Bモデルを20GBとして掲載しています。これは配布するモデルファイルの容量です。GPUで推論を続けるときの総使用量ではありません。
| Ollamaのタグ | 公開ファイル容量 | 20GBカードでの扱い |
|---|---|---|
| qwen3:8b | 5.2GB | 重み以外に広い余裕が残る |
| qwen3:14b | 9.3GB | 会話履歴と作業領域を残しやすい |
| qwen3:30b | 19GB | 残りが約1GBで余裕が小さい |
| qwen3:32b | 20GB | ファイル容量だけで公称VRAMと同じ |
14Bはモデル本体を載せた後にも約10GBの公称容量が残ります。OSの画面表示や推論ソフトの管理情報も同じGPUメモリを使いますが、30Bや32Bより設定の自由度が高い構成です。30Bはファイルだけで19GBを使うので、長い文脈や複数ユーザーを同時に処理したい用途では、GPU外への退避や文脈長の削減が必要になりやすいサイズです。
実際のメモリ配分
LLMの実行時には、重み、KVキャッシュ、作業バッファー、画面表示や他アプリの領域が重なります。会話の入力が長いほどKVキャッシュは増えます。20GBのカードで使うなら、最初は14B級の量子化モデルを一つロードし、実行ソフトが表示するGPUメモリ使用量を見て文脈長を調整する方法が実用的です。モデルファイル9.3GBと公称容量20GBとの差を、KVキャッシュや画面表示などの実行領域へ残せます。
NVIDIAの公式仕様は20GBのECC対応GDDR6を示します。ECCはメモリ内の特定のビット誤りを検出・訂正する機能です。データシートのメモリ帯域は280GB/s、消費電力は70Wです。推論速度にはメモリ帯域、計算量、モデル形式、利用するソフトの実装が関係します。20GBという容量だけでトークン毎秒を決めることはできません。
小型ワークステーションでの構成
70Wで補助電源が不要なカードは、GPU用の電源ケーブルを追加しにくい小型PCに組み込みやすい選択肢です。1台のPCで画面出力とローカルLLM推論を兼ねる構成では、表示用メモリも20GBから消費します。メモリをほぼ使い切る32B級より、8Bから14B級を使って作業領域を残す設計が扱いやすくなります。
データシートではNVLink非対応です。複数のカードを使う場合も、一つの大きなGPUメモリとして自動的に統合されるわけではありません。モデルを分割するには対応ソフトの設定が必要です。まず1枚の20GB枠で用途を決め、必要ならより大容量のカードと比較する順番が明確です。
モデルファイルと実行用メモリ
OllamaのQwen3タグ一覧では、8Bが5.2GB、14Bが9.3GBです。8Bを使う場合、公称20GBからファイル容量5.2GBを引くと14.8GBが残ります。14Bでは同じ計算で10.7GBです。実際にはモデル以外の領域も使うため、この数字はVRAMの空き容量そのものではありませんが、文脈長や同時利用数を決める際の比較基準になります。同じパラメータ数でも量子化方式が変わると配布ファイルの容量は変化します。Ollamaの一覧に示した9.3GBは「qwen3:14b」の値です。異なるタグのモデルへ切り替える場合は、そのファイル容量を使って20GBとの差を計算できます。
30Bの19GBという表示は、20GBとの差がわずか1GBです。モデルの重みの置き方、KVキャッシュ、GPU画面表示まで考えると、全レイヤーをGPUに置く構成は厳しくなります。実行ソフトが一部をシステムメモリへ移すと、その部分はCPUとメインメモリ経由で処理され、応答速度の目標も変わります。14B以下をGPU上に無理なく置きたい場合に、本機の容量を評価できます。
回答品質にはモデルの能力、量子化、プロンプト、参照データが関わります。GPU仕様にある第4世代Tensorコアや19.2 TFLOPSも、使用する推論ソフトの対応や量子化形式と結び付けて初めて速度に効きます。実際のトークン毎秒を示す本機固有の統一ベンチマークは、ここで挙げた公式資料には掲載されていません。
まとめ
RTX 4000 SFF Adaの20GBは、OllamaのQwen3 14Bなど、9GB台の量子化モデルに十分な作業余地を残します。19GBや20GBの配布ファイルは実行時の追加メモリが逼迫するため、同じようには扱えません。70Wの小型PCでローカルAIを動かすなら、モデル本体と会話履歴の両方が収まるサイズから始めると、カードの特徴を活かせます。価格と用途の記事で購入判断も整理しています。