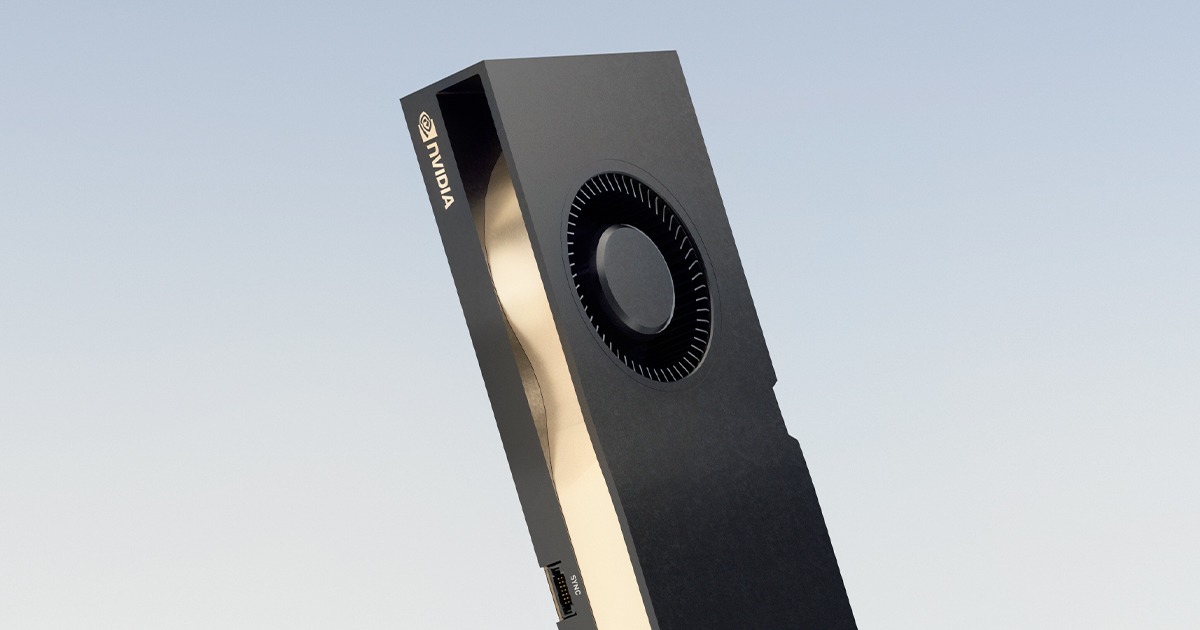
RTX A5500はNVLink対応の24GBカードです。2枚で「48GB」と案内されますが、容量の扱いはソフトの実装に左右されます。大型シーンやAIモデルのために2枚構成を検討する人向けに、NVIDIAの脚注まで含めて必要な条件を整理します。
2枚構成の仕様
NVIDIAのA5500データシートは、薄型NVLinkブリッジで2枚を接続し、双方向112.5GB/sの帯域を得られると示します。1枚あたり24GB GDDR6 ECCなので、2枚の物理メモリは合計48GBです。資料の脚注は、メモリ拡張にアプリ側のNVLink対応が必要と明記しています。
NVLinkはGPU間の高速な通信路です。アプリが両GPUへ処理とデータを分散する構成で、合計48GBの物理メモリを活用できます。
また、双方向112.5GB/sはNVIDIAが示すリンク全体の仕様値です。2枚を合わせたローカルメモリ帯域幅がこの数字へ置き換わるわけではありません。各A5500はそれぞれ768GB/sのローカルメモリ帯域を持ち、GPU間へ移すデータだけがNVLinkを通ります。データ配置が悪いとGPU間通信が増えるため、アプリの分散方式が性能を左右します。
2枚構成の公称ボード電力はA5500だけで230W×2、合計460Wです。PCIe 8ピン補助電源は各カードに1本ずつ、カード幅は各2スロットを要します。ELSAの寸法情報ではカード長が約267mm。ブリッジを装着できるスロット配置、ケースの空き、排気経路、CPU等を含む電源容量を設計に織り込みます。
ELSAの発表ではNVLinkブリッジは別売です。対応するブリッジにはスロット間隔の仕様があるため、購入前にマザーボード上の2つのPCIeスロットの距離とカードの占有幅を照合します。筐体内で片方のカードの吸気を塞ぐ配置なら、長時間負荷の冷却にも影響します。
Blenderにおける分散メモリ
Blender Cyclesは複数GPUを使ったレンダリングをサポートします。ただし、複数GPUを選ぶだけでは各カードが同じシーンデータを保持するため、利用可能なシーン容量は1枚あたりのVRAMを基準にします。BlenderのGPUレンダリング資料は、NVLink接続されたNVIDIA GPUのメモリ共有に触れています。対応する版では「Distribute Memory Across Devices」を使い、複製するデータを減らして大きなシーンへメモリを割り当てます。
この設定の効果はシーン内のデータ配置とBlenderの版に依存します。48GBの全量がひとつのシーンにそのまま使えるという見込みで予算を組むより、対象シーンのテクスチャやジオメトリがどのくらい共有されるかを測る方が正確です。GPU間転送が増えればレンダリング時間にも影響するため、速度と収容容量は別々に評価します。
Blenderの用途なら、まず現在のピークVRAMと、24GBを超える場面があるかを特定します。24GB以内の案件が中心なら単体A5500で足り、複数GPUはレンダリングの並列化が目的になります。大型シーンが継続するなら、ソフト側の分散メモリ機能と、最初から大容量を1枚に載せられるGPUを費用と処理時間で比較できます。
ローカルAIの48GB運用
推論ソフトによっては、モデルを層単位やテンソル単位で複数GPUへ分割します。その場合、2枚の合計メモリを使って24GB超のモデルを扱える構成があります。必要なのは推論エンジンの複数GPU対応であり、NVLinkそのものがモデルを分割するわけではありません。推論ソフトによってはPCIe経由で分散でき、NVLinkの有無より実装方法の方が大きな条件です。
32Bパラメータの4bit重みは単純計算で約16GB、70Bは約35GBです。この値には量子化の追加情報、KVキャッシュ、実行時の作業領域を含めていません。24GBを超えるモデルで2枚目が必要になっても、各GPUへの配分とコンテキスト長によって必要な空き容量が決まります。ロード可能なモデルは、各GPUへの配分とコンテキスト長で決まります。
また、長いコンテキストではKVキャッシュの量が増えます。重みだけをぎりぎり収める構成より、余裕を残した分割の方が安定した運用をしやすくなります。使用する推論エンジンのGPU分散方式と、対象モデルの推奨メモリを合わせて判断します。
NVLinkを選ぶ順番
A5500のNVLinkは、対応アプリで大きな作業を扱うための選択肢です。まずアプリの2枚運用とメモリ分散の仕様、次にブリッジの対応とPCの実装条件、最後に導入費用を確認します。単体24GBで収まるなら追加投資の対象は速度か冗長な処理能力になります。24GB超が常態化するなら、48GB級の単体GPUとも価格と保守のしやすさを比較しましょう。