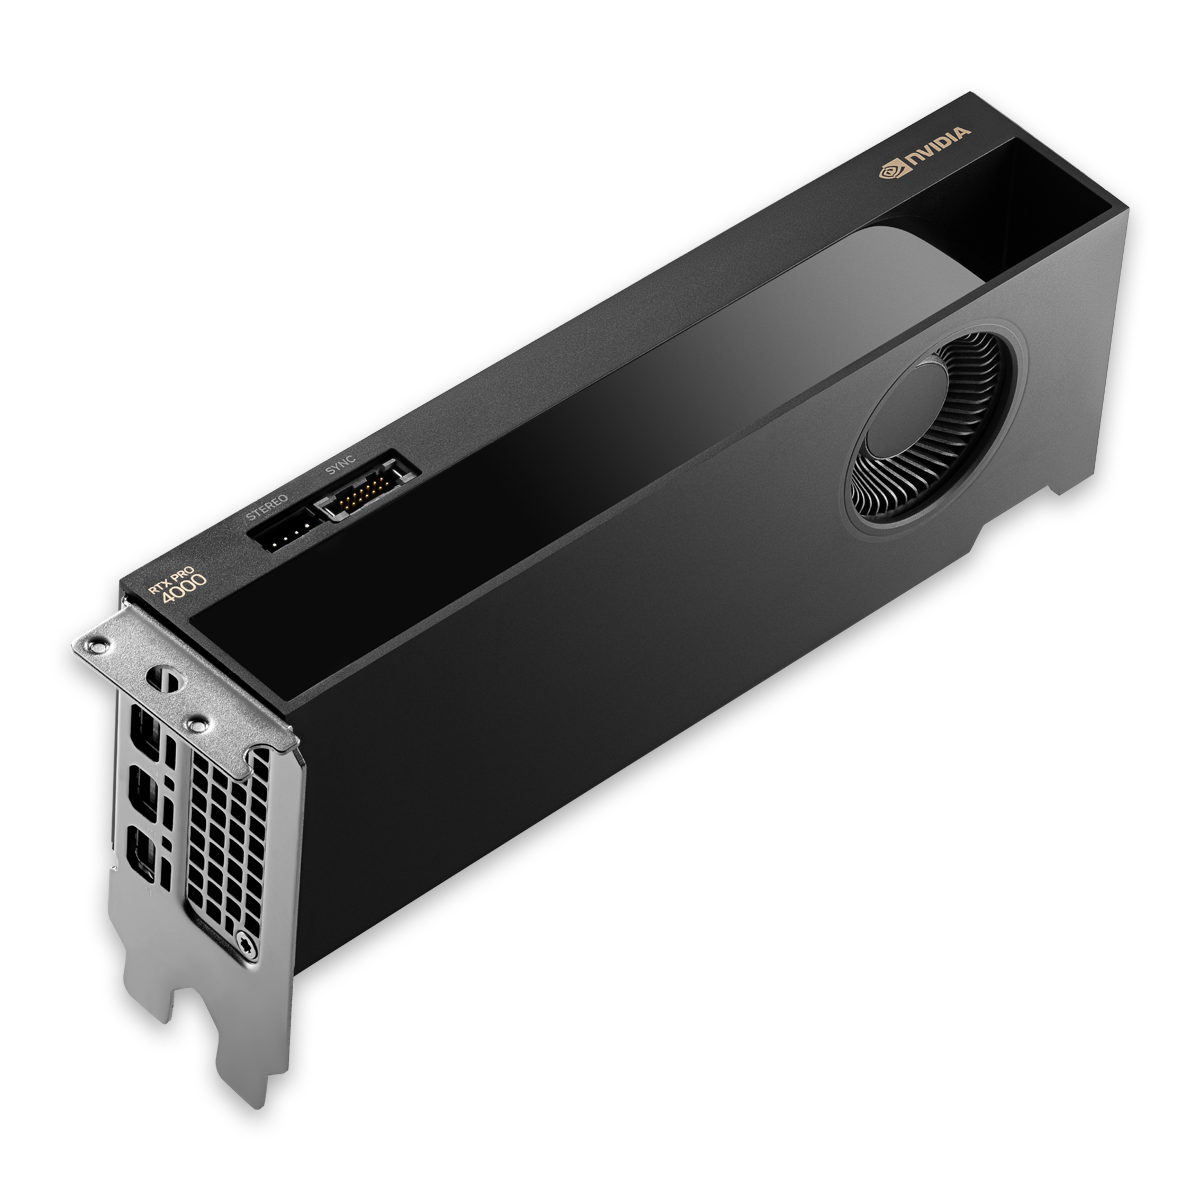
小型PCでローカルLLMを動かすために、24GBのVRAMを持つRTX PRO 4000 Blackwell SFF Editionを検討する人もいるでしょう。このカードは70Wで補助電源が不要な一方、推論速度や載せられるモデルは24GBという数字だけでは決まりません。配布モデルのサイズと、推論時に増えるメモリ使用量を分けて考えると、用途に合うモデルを選びやすくなります。
24GBに収まるモデルの目安
NVIDIAの仕様表によると、SFF EditionのGPUメモリはECC対応のGDDR7が24GBです。OllamaのQwen3配布一覧には、8Bが5.2GB、14Bが9.3GB、30Bが19GB、32Bが20GBと表示されています。これは配布物のサイズであり、起動後のGPUメモリ総使用量を表す数字ではありません。
| Ollamaのタグ | 配布サイズ | 24GBカードでの見方 |
|---|---|---|
| qwen3:8b | 5.2GB | 重み以外の領域にも余裕を残しやすい |
| qwen3:14b | 9.3GB | 会話用のキャッシュを確保しやすい |
| qwen3:30b | 19GB | コンテキスト長と同時実行数が効く |
| qwen3:32b | 20GB | 長い文脈では余裕が小さい |
モデルの量子化方式やタグが異なれば配布サイズも変わります。まず使用したいタグの実際のファイルサイズを基準にし、そこへ会話履歴のキャッシュ、実行バッファ、画面表示のためのメモリを足します。20GBの配布物を使う場合、残る約4GBの枠にはそれらの実行時データも収めます。
KVキャッシュとコンテキスト長
LLMは入力と生成済みのトークンを参照するため、推論中にKVキャッシュを保持します。会話を長くしたり、複数リクエストを同時に扱ったりすると、この領域が増えます。llama.cppのサーバー設定には、コンテキスト長、KVキャッシュの型、GPUに載せるレイヤー数を調整する項目があります。大きいモデルでGPUメモリが足りない場合は、コンテキスト長を短くするか、一部レイヤーをCPU側に置く構成へ変えられます。
前者は一度に参照できる文量を減らし、後者はGPUとシステムメモリの間の移動を増やします。24GBのカードを選ぶ利点は、14B前後のモデルなら長めの会話や別のGPU作業に余裕を作りやすく、30B級にも設定次第で届くことです。32B級を使う目的なら、重みのサイズだけでなく実際に指定するコンテキスト長を含めたメモリ使用量で判断します。
具体的には、同じ30Bモデルでも短い質問を1件だけ処理する構成と、長文資料を読み込んで複数人が同時に使う構成では、必要なKVキャッシュが違います。llama.cppサーバーのコンテキスト長と同時リクエスト数は、その差を生む設定です。まず単独の短い会話でGPUへの搭載状況を見て、次に実際に使う文書量と同時利用数へ合わせると、24GBの余裕を具体的な用途に結び付けられます。
70Wと432GB/sが意味すること
SFF EditionはNVIDIAの公式資料で70W、メモリ帯域432GB/sです。同じRTX PRO 4000 Blackwellのフルハイト版は、製品ページで帯域672GB/sと示されています。容量はどちらも24GBですが、SFF版は小型筐体と電力上限に合わせた構成です。
LLMの体感には、重みを読み出す帯域だけでなく、プロンプト処理、量子化形式、GPUに置いたレイヤー、バッチ処理も関係します。NVIDIAの770 AI TOPSはFP4とスパース性を使う条件の理論値です。Ollamaの生成速度は、同じモデル・量子化方式・コンテキスト長で測定したトークン毎秒で比較します。LLMの容量選びに加え、トークン生成速度まで知りたい場合は、この条件を揃えた測定値を使います。
導入の実際
Ollamaで試すなら、まずOllama公式のQwen3一覧から用途に近いモデルを選びます。会話とコードの通常利用ならqwen3:14bは配布サイズが9.3GBで、24GBとの間に余地を取りやすい候補です。大きなモデルの精度を試したいときは30B・32Bの配布サイズとコンテキスト設定を合わせて検討します。モデルを起動したらGPU使用量を見て、処理がGPU側で行われているかを確認する流れです。
カードは補助電源不要なので、小型ワークステーションへ24GBを追加しやすい構成です。ロープロファイルで2スロット厚のため、筐体には隣接スロットと吸気空間を確保します。PCIe接続はGen5 x8、端子形状はx16で、ELSAはGen4以降のスロットを推奨しています。
まとめ
RTX PRO 4000 Blackwell SFF Editionの24GBは、Qwen3の8B・14Bを余裕を持って扱い、30B級にも手が届く容量です。32B級は配布サイズだけで20GBあるため、長い会話や同時利用では設定が効きます。まず14Bで必要な回答品質と速度を見て、より大きなモデルへ進むならKVキャッシュ込みのGPU使用量を確かめると、24GBを生かせます。小型PCへの搭載条件は70W・補助電源の記事で整理しています。