NVIDIA RTX SparkとPAIRが発表され、ローカルAIを動かすPCの考え方が変わり始めています。新しいRTX Sparkは、AI処理とゲームを1台でこなすWindows PC向けのSoCとして10月に登場する予定です。PAIRは、すでに家にある複数のRTX PCをローカルネットワークでつなぎ、独立した推論リクエストを空いているGPUへ振り分けます。
この記事では、NVIDIAのIFA 2026発表を基準に、RTX Sparkの構成、PAIRの仕組み、対応環境、導入手順を整理します。新製品を待つ人と、手元のGPUでローカルAIを試したい人が、必要な機材と得られる効果を判断できる内容です。
IFA 2026で発表された内容
NVIDIAは2026年9月3日、IFA 2026に合わせてローカルAI関連の複数の更新を発表しました。中心となるのは、Windows上のローカルエージェントを導入しやすくするソフトウェア対応、推論バックエンドの高速化、家庭内PCを活用するNVIDIA Personal AI Router(PAIR)、そしてRTX Spark搭載Windows PCです。
| 発表 | 内容 |
|---|---|
| RTX Spark | RTX Blackwell GPU、Grace CPU、統合メモリーを組み合わせたWindows PC向けSoC。新製品は2026年10月予定 |
| PAIR | 同じネットワーク上の対応PCへ、独立したAI推論リクエストを振り分ける無償のオープンソースソフトウェア |
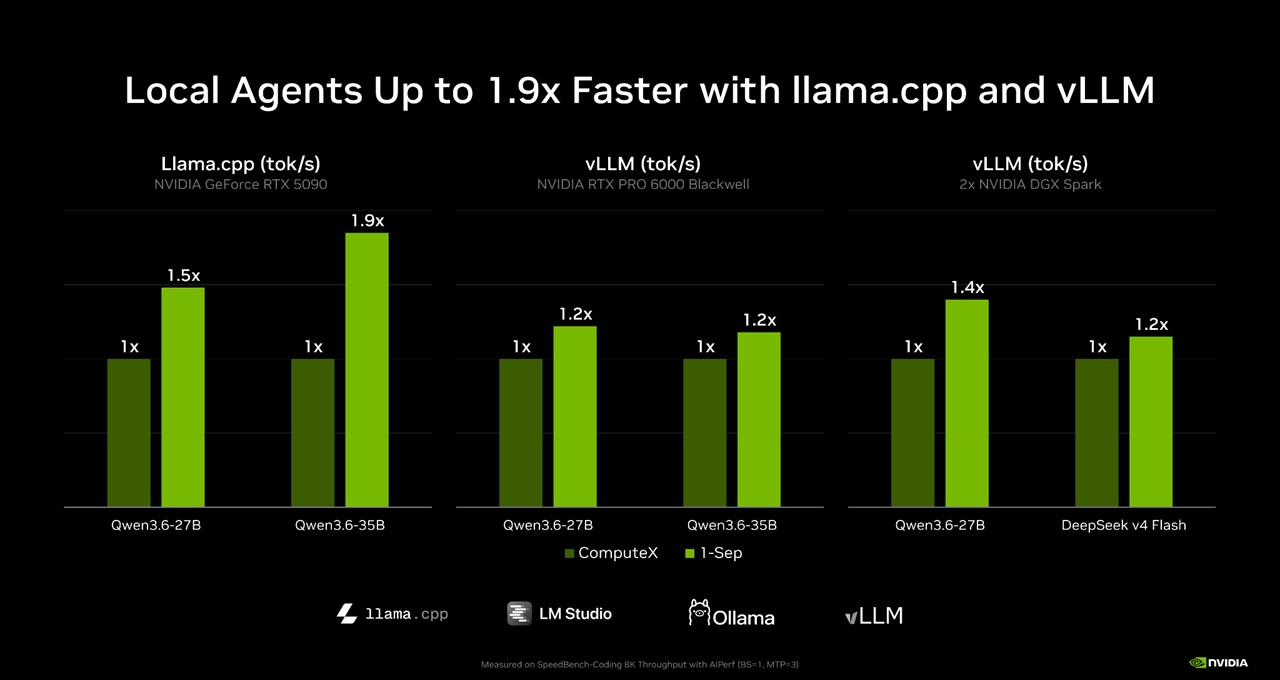
| 推論最適化 | NVIDIAはllama.cppで最大1.9倍、vLLMで環境に応じた高速化を案内 |
| ローカルAIアプリ | Hermes Agent、OpenClaw、Perplexity Portable ComputerのNVIDIA GPU向け導入を簡単にする対応 |
RTX SparkはCPU、GPU、メモリーを1つのシステムとして搭載するノートPCや小型デスクトップの製品群です。PAIRは既存PCを活用するソフトウェアなので、両者は「新しいAI PC」と「いま持っているPCの連携」という別の入口からローカルAIを広げます。
RTX Spark N1Xの2構成
RTX Sparkの詳細を報じたTom’s HardwareとWindows Centralは、N1Xに2種類の構成があると伝えています。現時点で確認できる違いは次のとおりです。
| 項目 | 上位構成 | ノート向け構成 |
|---|---|---|
| GPU | Blackwell GPU 6,144コア | Blackwell GPU 5,120コア |
| CPU | 20コアGrace CPU | 18コアGrace CPU |
| 統合メモリー | 24〜128GB | 24〜32GB |
| 想定フォームファクター | ノートPC・小型デスクトップ | ノートPC |
NVIDIAの公式発表では、RTX Sparkは1ペタフロップ級のRTX Blackwell GPU、最大128GBの統合メモリー、20コアGrace CPUを備えるシステムとして紹介されています。統合メモリーは、CPUとGPUが同じメモリー領域を使う設計です。グラフィックボードのVRAMとは役割が異なり、OSやアプリケーションも同じメモリー領域を共有します。
大規模なローカルモデルを扱うときは、GPUコア数だけでなく、モデルを何ビットで量子化するか、コンテキスト長をどこまで確保するか、OSやアプリが使うメモリーをどれだけ残すかが効きます。最大128GBという数字はモデル配置の自由度を広げますが、すべての容量が推論だけに使えるわけではありません。実際の製品ではOEMごとの冷却、電力設定、ストレージ、メモリー容量を確認する必要があります。
発売時期は2026年10月です。NVIDIAは新しいWindows PCをLenovoとAcerが展示したと説明し、既存のOEMもRTX Spark製品を展開すると案内しています。Tom’s Hardwareの報道時点では価格は公表されていません。購入を決めるときは、同じN1Xでもメモリー容量と画面・冷却・ストレージ構成を分けて比較することになります。
RTX Sparkで想定される用途
NVIDIAはRTX Sparkを、クリエイター、ゲーマー、AIエージェント利用者向けのWindows PCとして位置付けています。ローカルでモデルを動かす場合、入力データを外部サービスへ送らずに処理できることが導入理由になります。NVIDIAの発表では、Windows Agent Frameworkと組み合わせ、バックグラウンドで動くエージェントをOS側の制御下で実行する構想も示されています。
ゲームについては、Electronic Arts、Embark、UbisoftなどがRTX Spark向けの対応を進めているとNVIDIAが発表しました。ArmベースのWindows PCでは、ゲームの互換性やドライバー対応が製品選びの条件になります。対応タイトルが増える計画はありますが、すべての既存ゲームが同じ条件で動くと決まったわけではありません。購入前に遊びたいタイトルの対応状況と、OEMが公開するゲーム性能を確認しましょう。
ソフトウェア側では、NVIDIAがllama.cppのRTX 5090環境で最大1.9倍のスループット、vLLMでRTX PRO 6000 BlackwellやDGX Sparkを使った高速化を案内しています。これらはNVIDIAが示した特定のモデル・設定・バックエンドでの値です。RTX Sparkのすべてのアプリが同じ倍率で速くなるという意味ではありません。モデル、量子化、バッチサイズ、メモリー帯域をそろえて比較する必要があります。
PAIRの仕組み
PAIRは、家庭や小規模な作業環境にある複数のPCへ、ローカルAIの仕事を配る仮想推論ルーターです。NVIDIAの技術解説では、OllamaとLM Studioの既存インターフェースを利用し、エージェント側に新しいクラスタAPIを組み込まずに使えると説明されています。
ローカルエージェントが複数のサブタスクを同時に投げると、1台のGPUにリクエストが集中します。PAIRはネットワーク上の対応ノードを発見し、エンジンの稼働状況、モデルの有無、GPUの利用状況などを見て、処理できるノードへ独立したリクエストを転送します。メインPCで作業を続けながら、別のデスクトップやノートPCの空き時間を推論に使える点が特徴です。
対応環境はWindows、macOS、Linuxです。NVIDIA GeForce RTX 20シリーズ以降、Turing世代以降のRTX PROワークステーションGPU、DGX Spark、Apple M4以降のシステムが案内されています。NVIDIAはPAIRを無償のオープンソースソフトウェアとして提供しており、公式ドキュメントから構成と動作を確認できます。
PAIRでできることとできないこと
PAIRが得意なのは、複数の独立したリクエストを同時に処理するワークフローです。調査を分担するエージェント、コードを複数の観点から確認する作業、文書を分割して要約する処理など、個別の推論を並列化できるほど待ち時間を短縮しやすくなります。NVIDIAは、空いているPCへ処理を移し、メインPCをゲームや制作に戻せる点も用途として挙げています。
PAIRの役割は、独立したリクエストを処理できるノードへ振り分けることです。複数GPUのメモリーを合算して1枚の大きなGPUにする機能や、1つのモデル・実行中リクエストを複数PCへ分割する機能は備えていません。NVIDIAのドキュメントでは、各ノードが必要なモデルを自分で保持し、1つのリクエストは1台のノードで最後まで処理すると説明されています。
そのため、同じモデルを処理できるPCが多いほど振り分け先が増えます。モデルを1台にしか置いていない場合、そのモデルを必要とするリクエストはそのPCに送るしかありません。長い1回の生成を分散して短縮する用途より、複数の短い処理が並行して発生する用途に向きます。
PAIRの導入手順
PAIRのセットアップ手順では、次の流れでクラスタを作ります。
- 参加させる各PCへPAIRをインストールします。
- ローカルネットワーク上でノードを検出し、表示されたPINでペアリングします。検出できない場合はIPアドレスを指定します。
- 各ノードでOllamaまたはLM Studioを起動し、処理に使うモデルを追加します。
- 複数ノードへ同じモデルを配置し、どのPCでも同じリクエストを処理できる状態にします。
- 作業用PCのPAIRが表示するローカルエンドポイントを、対応アプリの接続先に設定します。
アプリケーションは、作業中のPCにあるPAIRのローカルエンドポイントへ接続します。PAIRがクラスタ内のノードを選び、エンジンが起動してモデルを保持するノードがリクエストを処理します。NVIDIAの手順では、エンドポイントは実際に処理を担当する遠隔PCの位置を意識せずに利用できます。
既存GPUユーザーとRTX Sparkの選び分け
すでにGeForce RTX 20シリーズ以降のPCを複数持ち、OllamaやLM Studioで独立したリクエストを並列処理している人は、RTX Sparkを購入しなくてもPAIRを試せます。GPUを増設する前に、モデルを配置できるメモリー容量、ネットワーク接続、各PCの稼働時間を確認すると、実際に増える処理量を見積もれます。
1台で大きなモデルを動かしたい場合は、PAIRのノード数を増やすだけではメモリー容量は増えません。既存のGeForce RTX 5090の32GB VRAMや、動画編集とローカルAIを組み合わせるRTX 5090のNVENC解説のように、1台あたりのVRAMと用途を確認する記事が参考になります。
RTX Sparkは2026年10月から登場予定の完成品PCです。統合メモリーを重視し、薄型ノートや小型デスクトップでゲームとローカルAIを両立したい人は、N1Xの構成と価格が公開されてから比較すると選びやすくなります。既存PCを活用できる人はPAIR、新しい筐体・統合メモリー・省スペース性を求める人はRTX Sparkという分け方が現時点の判断軸です。
まとめ
画像はNVIDIAの公式発表で公開された素材です。NVIDIAはIFA 2026で、最大128GBの統合メモリーを搭載するRTX Spark Windows PCを10月に投入する計画と、家庭内の対応PCへ独立したAI推論を配るPAIRを発表しました。RTX Sparkは新しいAI PC、PAIRは既存のGPU資産をつなぐソフトウェアです。
PAIRはGPUメモリーを合算せず、同じモデルを持つノードへリクエストを振り分けます。複数のサブタスクを並列処理する人ほど効果を活かしやすい設計です。RTX Sparkの価格とOEMごとの詳細が出たら、統合メモリー容量、冷却、ストレージ、ゲーム対応を既存のGeForce構成と比較しましょう。NVIDIAのローカルAI基盤をさらに知りたい方は、物理AI向けCosmos 3の解説もご覧ください。