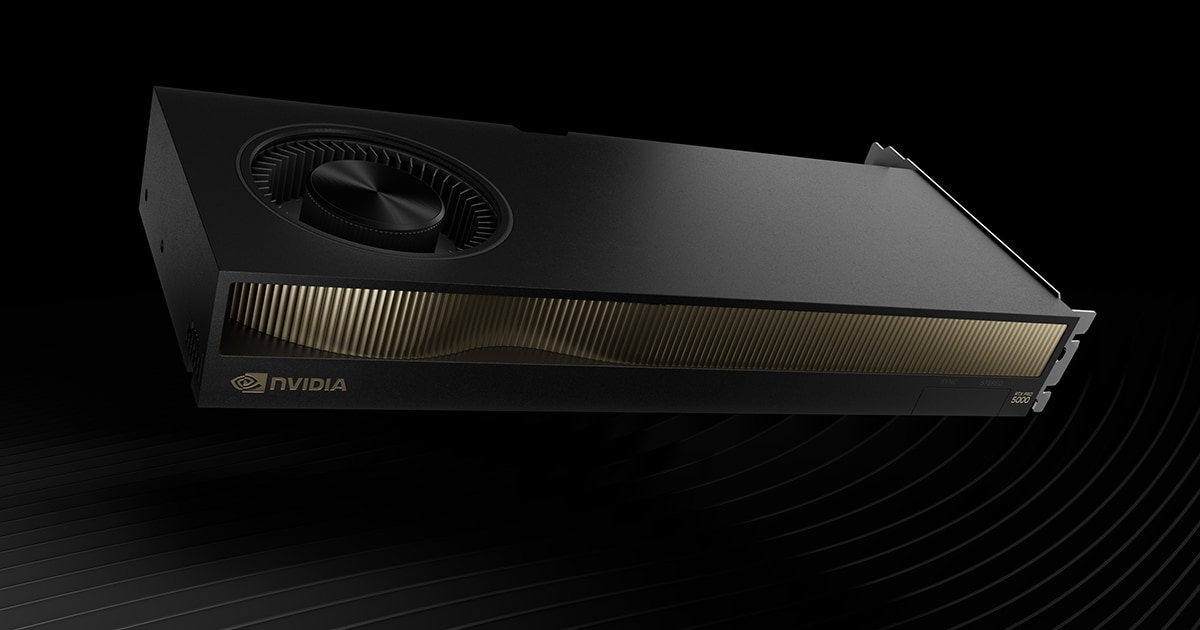
ローカルLLM用GPUとしてRTX PRO 5000 Blackwell 48GBを検討するなら、「48GBでどのモデルまで動くか」が最大の疑問でしょう。モデルの名前やパラメータ数だけでは、必要VRAMは決まりません。重みの量子化、文脈長、同時利用数を合わせて見積もる必要があります。NVIDIAの仕様とllama.cppの設定資料を基に、購入前に使える容量の考え方をまとめます。
48GBのVRAMが受け持つもの
NVIDIAの公式製品ページは48GBのGDDR7 ECCと1,344GB/sのメモリ帯域を示します。ECCはメモリの誤りを検出・訂正する仕組みです。LLMでは、モデルの重みに加えて入力履歴のKVキャッシュ、実行中の計算用バッファなどがVRAMを消費します。
たとえば重みファイルが40GBなら、単純な引き算では8GBの余裕があります。しかしGPU側に展開した形式、KVキャッシュの精度、長いコンテキスト、並列リクエストで消費量が増えます。実際の可否は、モデルファイル、起動オプション、同時セッション数を一組にして判定します。アプリの起動ログに表示されるGPUバッファ割り当てを確認すると、容量の内訳が見えます。
量子化とコンテキスト長
量子化は重みを低いビット数で記録し、容量を抑える方法です。精度と速度にはモデルや実装による差があるため、用途に使うテスト質問で応答品質を比べます。4ビット版のファイル容量から「必要VRAM=ファイル容量」と決めると、KVキャッシュなどが抜け落ちます。モデル配布ページの量子化方式とファイルサイズを出発点に、起動時の実使用量まで確認します。
llama.cppのサーバー設定にはコンテキスト長、並列処理数、KVキャッシュの型を変えるオプションがあります。長文の文書を一度に読ませるならコンテキストが増え、KVキャッシュの容量も膨らみます。複数人で同時利用するサーバーなら、推論中の状態を保持する領域も増えます。短い対話を1本だけ動かす構成と、長文処理を並列で回す構成は、同じモデルでもVRAM要求が異なります。
GPUに載り切らない場合
llama.cppはGPUへ載せるレイヤー数を指定でき、残りをCPU側で処理する構成も選べます。これにより48GBを超えるモデルを起動できる場合がありますが、CPU側の演算とメモリ転送が応答速度を左右します。使用するCPUとシステムメモリ、PCIe接続まで含めて構成を考えます。GPU内で完結する運用を目指すなら、退避前提の見積もりより72GB版を検討するほうが明確です。
NVIDIAのデータシートは48GB版と72GB版で14,080 CUDAコア、1,344GB/s、300Wを共通仕様にしています。追加の24GBで、モデルと実行中の状態を置く場所が増えます。48GB版でモデルが収まるなら、72GB版の増額が速度を大きく変えるとは推定できません。
1枚を分けて使う場合
RTX PRO 5000は最大2つのMIGインスタンスへ分割できます。データシートの上限は、48GB版で2×24GB、72GB版で2×36GB。複数の利用者に分離した実行環境を配るなら、1枚全体の48GBではなく各インスタンスの容量がモデル選択を制約します。単独利用時はMIGを使わず、48GBを1つの環境へ割り当てる構成も可能です。
国内のPGダイレクト製品一覧では、確認時に72GB版が48GB版より365,860円高く表示されました。共有運用で24GBインスタンスでは足りないモデルを使うなら、この追加額に目的があります。単独の小中規模モデル推論なら、まず48GB版で必要なコンテキスト長まで収まるかを見積もりましょう。
まとめ
RTX PRO 5000 Blackwell 48GBは、重み、KVキャッシュ、計算バッファを合わせた使用量が48GB内に収まるローカルLLM環境に向きます。量子化方式とコンテキスト長、同時利用数を決めると必要VRAMを判断できます。複数ユーザーにGPUを分ける構成や48GB超の実使用量が見えているなら、48GB版と72GB版の比較を参考に容量を選んでください。