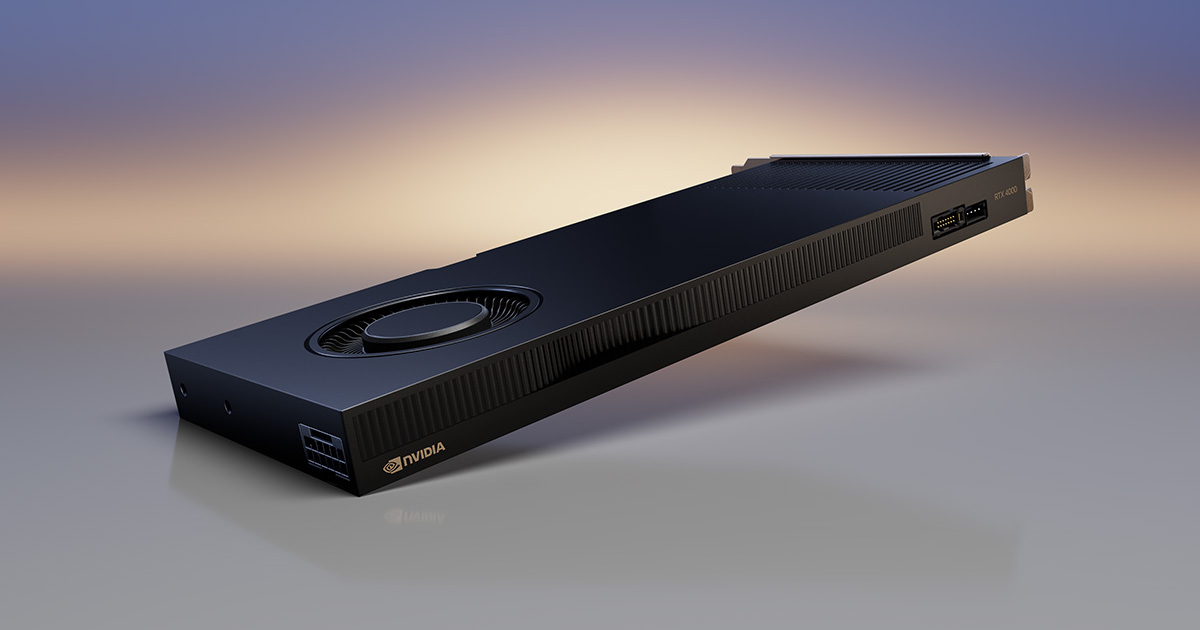
ローカルLLM用のGPUでは、演算性能と同じくらい、モデルをGPUメモリに載せられるかが選択を左右します。RTX 4000 Adaは20GB ECCメモリを備えた単スロットカードです。モデルの量子化サイズ、推論時の追加メモリ、20GBで組める環境を分けて考えると、購入条件が具体的になります。
20GBで何を置けるか
NVIDIA RTX 4000 Ada Generationは20GBのECC対応GDDR6メモリを搭載し、メモリ帯域は360GB/sです。NVIDIAのデータシートには第4世代Tensorコア192基、最大ボード電力130Wも示されています。ローカルLLMでは、最初にモデル重みを収める容量、その後に推論中のKVキャッシュや実行バッファを置く余裕を見ます。
llama.cppの量子化資料には、Llama 3.1 8BのQ4_K_M版が約4.9GB、70Bの同方式が約43.1GBという例があります。8Bなら20GBメモリに余裕を残せる一方、70BのQ4_K_Mを1枚のRTX 4000 Adaへ丸ごと載せる容量はありません。モデル名だけで判断せず、実際に使うGGUFファイルのサイズを起点にします。
| 例 | 資料にあるQ4_K_Mのサイズ | 20GBとの関係 |
|---|---|---|
| Llama 3.1 8B | 約4.9GB | 重み以外の領域を大きく残せる |
| Llama 3.1 70B | 約43.1GB | 1枚のGPUメモリには収まらない |
llama.cppの実装にある量子化の一覧でも、Q4_K_M、Q5_K_M、Q8_0など方式によって8Bモデルのファイルサイズが変わります。精度を上げれば重みの容量が増え、同じ20GBに残る余裕は減ります。
推論時に増えるメモリ
GGUFファイルのサイズは必要VRAMの下限に近い目安ですが、実行時にはKVキャッシュ、計算用バッファ、CUDAランタイム、画面表示の領域なども要ります。llama.cpp開発者の説明でも、ロード時の各バッファ割り当てとコンテキスト長がVRAM消費へ影響するとされています。長い文書を一度に読み込む設定では、モデルの重みが同じでも必要量が増えます。
たとえば20GBのうち約18GBを重みに使うモデルは、コンテキストやバッチ用の余裕が小さくなります。短い質問では動いても長文入力でメモリ不足になる構成より、使用するコンテキスト長で余裕を残せるモデルを選ぶ方が安定します。推論アプリのロードログに重み、KVキャッシュ、計算バッファの割り当てが表示されるなら、その合計を容量判断の基準にできます。
一部の推論ソフトはモデルの一部をCPU側RAMに置く方式を提供します。GPUメモリを超えるモデルも起動し得ますが、GPUとCPUの間でデータを運ぶため、全レイヤーをGPUに置く構成と同じ速度にはなりません。70Bを主用途とするなら、43.1GBというQ4_K_M例の時点で20GB単体から構成を見直す理由が明確です。
演算性能とECCの位置づけ
RTX 4000 AdaのFP32理論ピークは26.7TFLOPSです。ただしLLMのトークン生成速度は、量子化形式、モデル構造、バッチ数、利用する推論エンジン、メモリ帯域に左右されます。FP32の値をトークン毎秒へ直接換算することはできません。同じモデルと同じ量子化形式で公表された実測があれば、そこで初めてGPU間の速度差を比較できます。
20GBのECC対応メモリは、長時間動かす業務ワークステーションに合った仕様です。ECCがモデルの回答精度を高めるわけではありません。大量の処理を続ける環境でメモリ誤りへの対策を持てる点が採用理由です。LLM専用に1台組む場合は、モデルサイズと推論速度の実測に加え、業務機でECCが必要かも分けて考えます。
物理構成と選び方
カードは長さ約241mmのフルハイト、1スロットです。最大ボード電力は130Wで、補助電源にはカード側の16ピン端子を使います。NVIDIAの製品資料にあるPCIe 4.0 x16の拡張スロット、ケース内の長さ、補助電源の経路を揃えます。複数の拡張カードを同時に使う研究・開発用PCでは、単スロットの形状が配置上の利点です。
8B級の量子化モデルを扱いながら、ほかの制作アプリも同じGPUで開く人には、20GBの余裕が有効です。より大きいモデルなら、実際の量子化ファイルとコンテキスト設定から必要容量を計算し、オフロードを許容するかを決めます。用途を特定すると、20GBが十分な余裕なのか、拡張が必要な容量なのかを判断できます。
まとめ
RTX 4000 Adaの20GBは、Llama 3.1 8BのQ4_K_M例なら重みを載せた後も余裕があり、70Bの同方式を単体で収めるには不足します。モデルファイルにKVキャッシュと実行バッファを加えた実使用量を基準に、量子化方式とコンテキスト長を選びましょう。