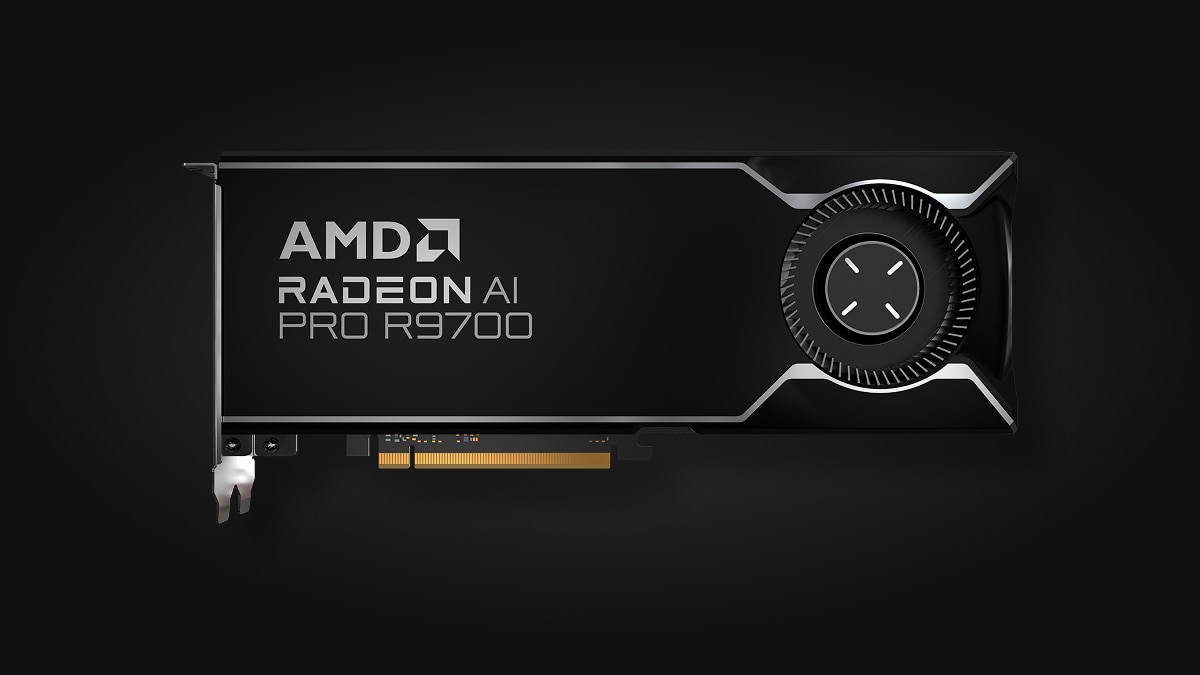
32GB VRAMでできること
Radeon AI PRO R9700の32GB VRAMなら、16GB級のカードでメモリ不足になりやすい大きめのローカルLLMを、GPUメモリ内に収めて動かしやすくなります。AMDはRadeon AI PRO製品ページでDeepSeek R1 Distill Qwen 32B Q6などを試験モデルとして挙げています。32BモデルのQ6重みだけを単純計算すると32B×6bit÷8で約24GBです。実際のファイル容量には形式ごとの情報が加わり、ロード後はKVキャッシュや実行環境の領域も使います。独立レビューのBack2Gamingも27BモデルをR9700のVRAM内に収めて検証しました。
モデル選びで見るべきなのは、パラメーター数だけではありません。モデルファイルの量子化、推論時のコンテキスト長、KVキャッシュ、実行環境が使う領域まで含めた合計が、利用可能なVRAMに収まるかで判断します。32GBという容量は、モデルの読み込みだけでなく長めの会話履歴や大きな文書を扱う余裕にもつながります。
量子化とモデルサイズの目安
重みだけを単純計算する場合、パラメーター数に1パラメーター当たりの保存ビット数を掛け、8で割ると概算できます。実際のモデル配布ファイルはメタデータや埋め込み、量子化方式の違いを含むため、この計算値から前後します。
| モデル規模 | 重みの量子化 | 重みの概算 | R9700で見るポイント |
|---|---|---|---|
| 8B | Q4 | 約4GB | KVキャッシュやコンテキストに大きな余地 |
| 14B | Q4 | 約7GB | Q5やQ6など高い精度も選びやすい |
| 27B | Q4 | 約14GB | 長い文脈や高精度設定を合わせて検討 |
| 32B | Q6 | 約24GB | 実ファイルとKVキャッシュを含めて確認 |
AMDのRadeon AI PRO製品ページはDeepSeek R1 Distill Qwen 32B Q6を試験モデルの一つに挙げています。Q6の重み容量を単純計算すると約24GBですが、実際のモデルファイルは形式ごとに違い、ロード後にはKVキャッシュと実行環境の領域も使います。独立レビューのBack2Gamingでは27BモデルをVRAM内に置いた結果が報告されており、R9700の32GBが中規模モデルのローカル実行に向くことを裏付けています。
コンテキスト長とKVキャッシュ
モデルをロードした後も、入力文と生成中のトークンを保持するためにVRAMを使います。会話履歴を長くしたり、ソースコードやPDFをまとめて入力したりすると、KVキャッシュが増えます。同じ重みファイルでも、短いチャットなら収まる設定が長文処理ではVRAM上限を超える場合があります。
構成を選ぶ際は、配布ページのファイルサイズだけで決めず、使う推論ソフトのメモリ表示を確認します。コンテキストを最大値へ固定するより、実際に必要な長さから始めて増やすと、モデルのロード後にメモリ不足で停止する状況を避けやすくなります。KVキャッシュの型をFP16から8bitへ変える設定を持つソフトでは、メモリ使用量と応答品質の両方を確認してください。
MoEモデルは総パラメーター数と、1トークンの計算に使う有効パラメーター数が異なる設計です。重み自体をVRAMへ置けるかは総サイズに左右され、生成時の計算量は有効パラメーター数や実装にも左右されます。モデル名にある「30B」だけから速度を推定せず、量子化ファイルと対象バックエンドの実測を確認しましょう。
16GBカードとの使い分け
16GBから32GBに増える一番の利点は、同じモデルを必ず高速に処理することではなく、モデルやキャッシュをGPUメモリに置きやすくなる点です。16GBではCPU側メモリへ一部を逃がす構成を検討する大きさのモデルでも、R9700なら全層をGPUへ配置できる可能性があります。GPUとシステムRAMの間でデータを移す工程が減るため、設定とソフトが対応していれば、待ち時間のばらつきも抑えられます。
32GBでも70B級モデルを任意の高精度設定と長いコンテキストで扱えるわけではありません。量子化を強くする、文脈を短くする、複数GPUへ分けるなど条件が変わります。より大きなモデルを常用したい場合は、二枚構成の64GB化とメモリ分割方式を扱うデュアルGPU構成の記事も確認できます。
モデルを決める手順
候補モデルを比較するときは、次の順で確認すると購入後の調整が簡単です。
- Hugging Faceなど配布元で、使いたい量子化ファイルの容量を確認する。
- 利用予定のコンテキスト長とKVキャッシュの形式を推論ソフトで設定する。
- モデル本体、キャッシュ、アプリの合計VRAM使用量を確認する。
- 余裕が小さい場合は、コンテキストを短くするか、ひとつ小さい量子化ファイルを試す。
- 応答速度が目的なら、容量だけでなくベンチマーク条件も照合する。
R9700の32GBは、27Bから32B級のモデルをローカルで試すときに選択肢を広げます。実際の収まり方はモデルの配布形式と文脈長で変わるため、導入前に使うファイルのサイズを調べるのが確実です。処理速度の実測値はLLMベンチマーク記事で、単体カードの容量を超える場合は二枚構成の記事で確認できます。