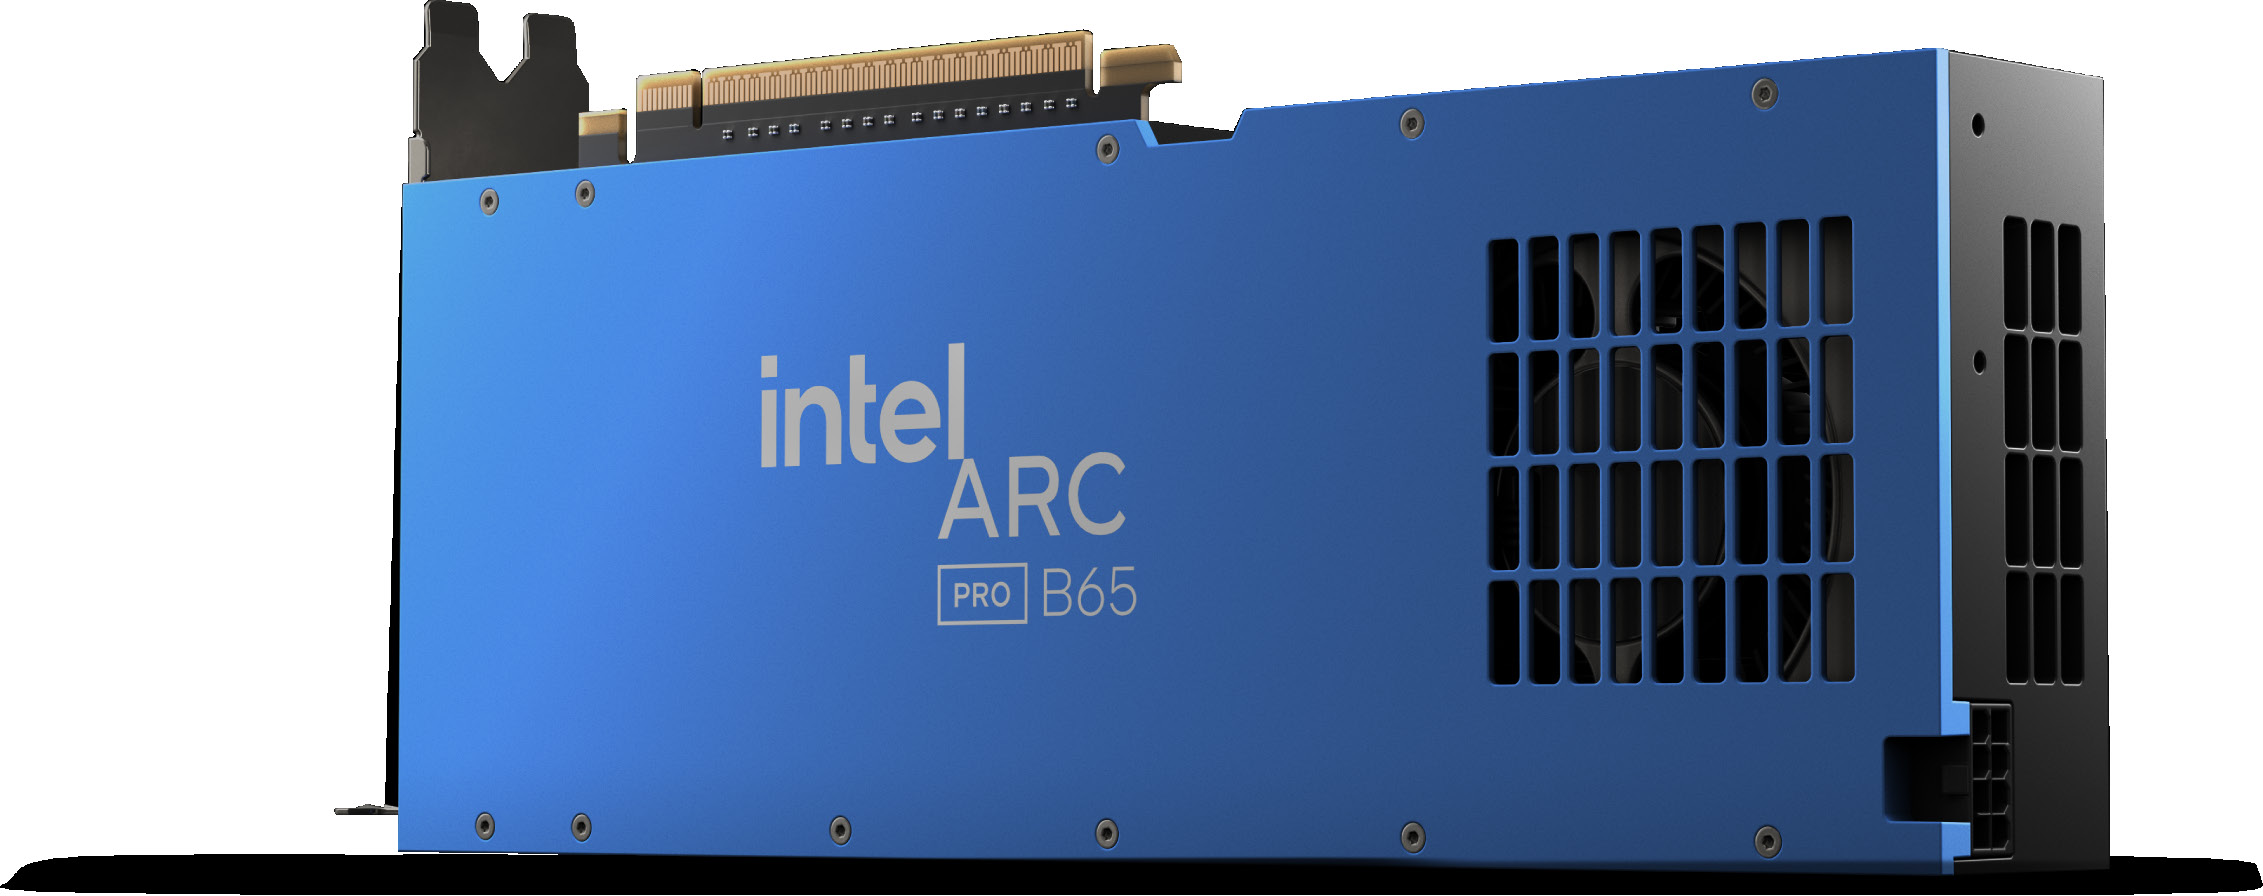
ローカルLLM用GPUを選ぶ際、モデル名だけから必要VRAMを判断するのは難しいものです。Arc Pro B65は32GBを搭載しますが、重みの量子化、コンテキスト長、利用するソフトで余裕は変わります。本記事ではメモリの見積もり方とIntel GPUでの実行経路を整理します。
B65の32GBが受け持つもの
IntelのArc Pro B65仕様は32GB GDDR6、608GB/s、20 Xeコア、160 XMXエンジンを掲げます。LLM推論では最初に、モデルの重みがGPUメモリへどの程度載るかが問題になります。実行時には重み以外にも、入力文の履歴を保持するKVキャッシュ、計算用の一時領域、ランタイム自体の領域を使います。
32GB全部を重みへ割り当てる想定は実運用に合いません。同じモデルでも、会話履歴を伸ばしたり複数ユーザーから同時に要求を受けたりするとKVキャッシュが増えます。モデル配布ページのファイルサイズを出発点に、使う推論ソフトが表示するGPU割り当て量まで確認すると、選べる量子化とコンテキスト長が見えてきます。
量子化別の大まかな計算
計算例として、32Bパラメータのモデルの重みを1パラメータ当たり4bitだけで単純計算すると約16GBです。8bitなら約32GB、16bitなら約64GBになります。実際の量子化ファイルにはスケール値などが加わり、モデルの構造によってサイズも変わります。さらにKVキャッシュなどの領域が必要です。このため、32Bの8bitを「32GBちょうどだから載る」とは判定できません。
70Bモデルを4bitで単純計算した重みは約35GBで、B65単体の32GBを超えます。32GBの強みは、24GBでは収まりにくい中型モデルや長めのコンテキストを扱う余地です。量子化ファイルの実サイズを基準にします。
Intel GPUでの実行経路
llama.cppのSYCLバックエンド文書はIntel Arc系列を対象に挙げ、GPUメモリ使用量が起動ログに出ることも説明しています。Intelのllama.cpp解説も、Intel GPUで実行する経路を示しています。B65でこの経路を試すなら、ドライバー、oneAPI関連環境、llama.cppのビルド設定を、利用するOS向けの現行手順で揃えます。
モデルを読み込んだ後は、ログに出るGPUへの割り当て量と生成速度を記録すると、量子化やコンテキスト設定を比較できます。重みの一部をCPU側に置く設定では、GPUメモリ不足を回避できてもCPUとGPU間の転送が増え、生成速度に影響します。
IntelはB65のINT8ピークを197TOPSとしています。この値はXMXを使う特定の条件の理論値です。llama.cppでのトークン毎秒は量子化形式、バックエンド、バッチ、入力と出力の長さによって変わります。B65実機を同一条件で測ったデータがない限り、197TOPSから生成速度を推定するのは避けます。
B60とB70の選び分け
IntelのBシリーズ比較表ではB60が24GB、B65とB70が32GBです。B60とB65のXeコア数、XMXエンジン数、INT8ピークは共通。24GBを超えるモデル構成を使うなら、B65の容量増に明確な意味があります。B60との違いも参照できます。
B70は同じ32GBながら32 Xeコア、256 XMXエンジン、367TOPSの公称値です。搭載できる重みの容量を増やす選択肢ではありません。同じモデルをより多く並列処理したい、あるいは演算側に余裕を求めるならB70が候補になります。実行速度の差は同一ソフトで測った結果で確認します。
導入前の構成
ASRock製B65 Creatorのような完成カードでは、GPU仕様に加えて補助電源端子とケース寸法の確認が必要です。ローカルLLMを長時間回すPCなら、GPUの発熱をケース外へ逃がせる吸排気も考えます。複数GPUで大きなモデルを分散する場合は、マザーボードのスロット間隔、電源容量、実行ソフトの分割対応が別途要件になります。
測るときに分ける二つの時間
LLMの使用感には、入力を読み終えて最初の出力が出るまでの時間と、出力を連続生成する速度があります。前者は長い入力文の処理、後者は1トークンずつの生成が中心で、負荷の性質が異なります。同じ「トークン毎秒」でも、入力処理と出力処理を混ぜた数値では比較しにくくなります。
B65を評価する際は、モデル名、量子化、入力長、出力長、同時要求数、バックエンドの版をそろえます。さらに起動ログのGPU割り当て量を見ると、32GBへどこまで載っているかが分かります。使うモデルが決まっていれば、B60の24GBで足りるか、B65の32GBが必要かも具体的に判断できます。
まとめ
Arc Pro B65の32GBは、モデルの重みだけでなくKVキャッシュを含めて中型LLMの設定を組むための容量です。使うモデルの量子化ファイルとランタイムの使用量から必要VRAMを見積もります。24GBを超える構成ならB65、同じ32GBで演算側を増やすならB70を比較するのが筋道です。