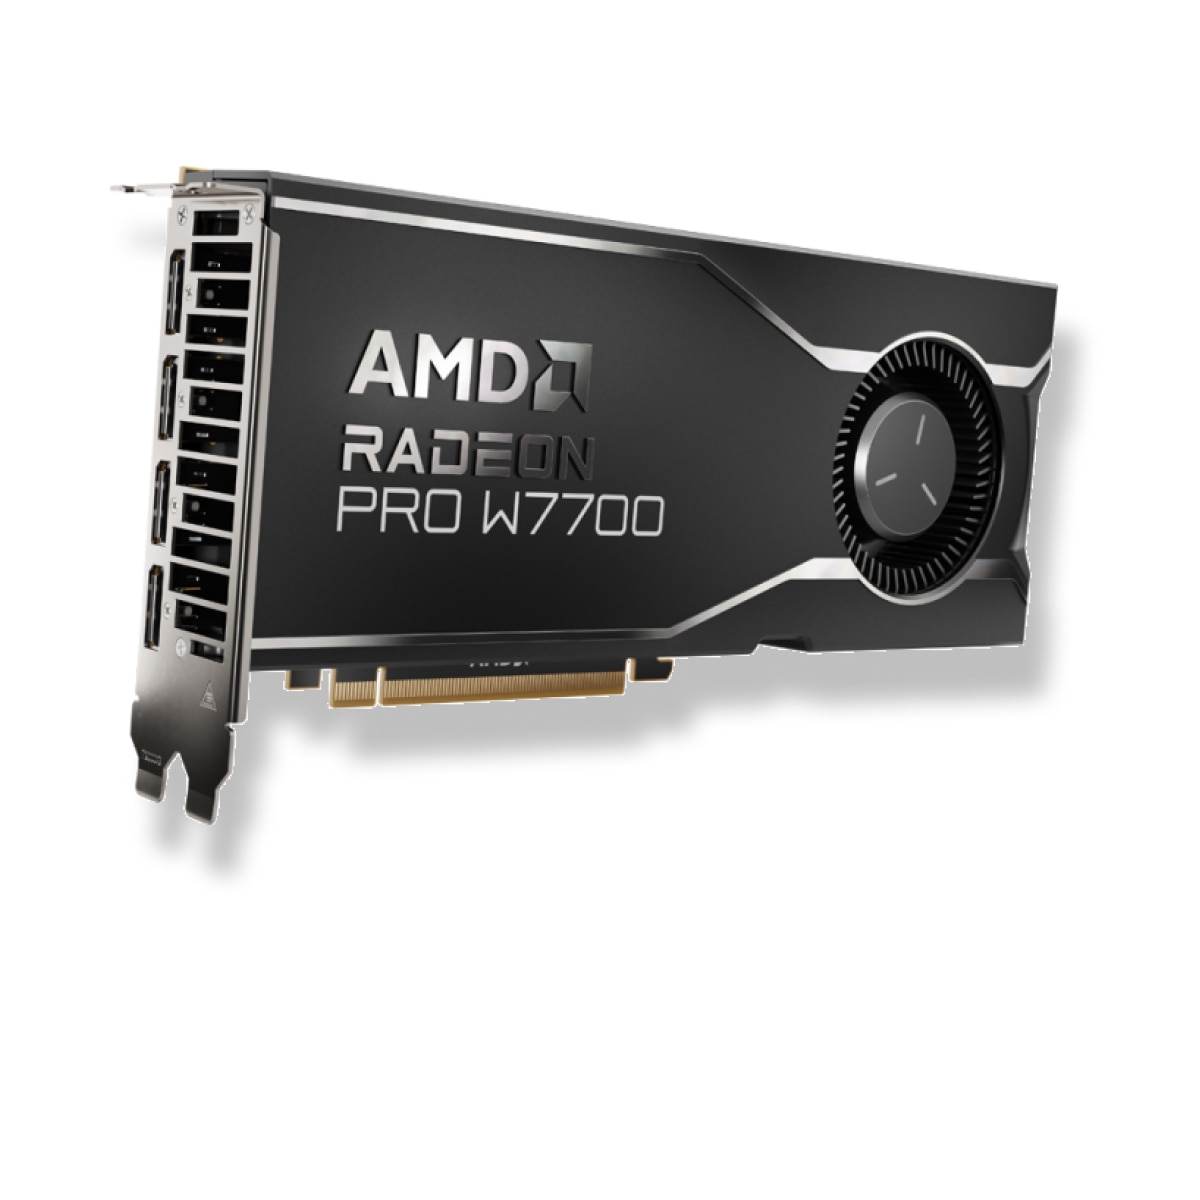
Radeon PRO W7700は16GBの専用メモリを持ち、AMDのROCm対応GPU一覧に載っています。ローカルLLMを動かす土台はありますが、モデルが入る容量と推論ソフトのバックエンドが性能を左右します。対応表で確認できる範囲と、16GBをどう使うかを整理します。
W7700のROCm対応
AMDのROCm対応ハードウェア一覧はRadeon PRO W7700をRDNA 3、LLVMターゲットgfx1101として掲載しています。W7700の製品仕様はGPUメモリ16GB、ECC対応、48 CUです。ROCmを利用する場合は、選択するROCm版の対応OSとドライバーの組み合わせに合わせて環境を作ります。使用する推論アプリには、そのアプリが提供するHIP対応ビルドを組み合わせます。
llama.cppのビルド手順にはHIPバックエンドがあり、AMD GPUで推論する実装を提供しています。ROCmの互換表と推論ソフトのドキュメントを合わせると、W7700で使う経路を確認できます。アプリの配布済みバイナリを使う場合は、そのバイナリにHIPが含まれるかも構成に入ります。
16GBの容量計算
LLMでは重みファイルだけでなく、実行時のキャッシュや作業領域もGPUメモリを使います。たとえばファイルサイズが10GBの量子化モデルなら、16GBとの差6GBが全て自由に使えるわけではありません。コンテキスト長を伸ばすほどキャッシュ使用量が増え、同時リクエストも容量を使います。選んだモデルの実ファイルサイズと起動時のGPUメモリ使用量を基準に設定します。
8GB級カードでは入りきらないモデルを、16GBのW7700ならGPU内に収められる場面があります。メモリ不足で一部をCPUへ逃がすと、GPUの計算性能だけを見た予想より推論が遅くなります。llama.cppにはGPUへ載せるレイヤー数の設定があるため、使用量に合わせて調整できます。16GB全体を重みで埋めず、キャッシュとシステムの余裕を残す方が安定した構成を作れます。
推論性能の見方
AMD仕様の28.3 TFLOPSや113 TOPSは、異なる精度と演算形態における理論最大値です。llama.cppの文字生成速度を直接表す数値ではありません。推論ではモデルの量子化方式、GPUメモリ帯域、トークン長、ソフトの実装が結果を変えます。W7700は256ビットのメモリバスと最大576GB/sの帯域を持つため、重みを繰り返し読む処理の土台があります。
W7700固有のトークン毎秒はここでは実測していません。モデル、量子化、入力長を統一した公開測定があれば推論速度の比較に使えます。
用途と構成の選択
W7700には映像出力が4基あり、画面を接続する作業用PCで推論とCAD・映像制作を両立できます。AMDは製品ページでワークステーション向けと位置づけており、190Wのボード電力、8ピン補助電源×1、推奨650W電源を示します。推論のために常時運転する構成なら、筐体内の通風と電源の余裕も合わせて設計します。
モデル容量と同時使用
量子化はモデルの重みを少ないビット数で保存し、GPUメモリ使用量を減らす方法です。同じ名前のLLMでも量子化版によってファイルサイズが変わります。まず使うGGUFファイルの容量を基準に、起動後のGPU使用量を確認します。コンテキストを長くするとKVキャッシュが増え、16GBの空きがさらに減ります。推論サーバーを複数人で使うなら同時リクエストの分も含めます。
W7700を画面表示やCADにも使うワークステーションでは、GPUメモリをLLMだけに割り当てられません。たとえば重みが8GBのモデルなら、残り約8GBをキャッシュ、表示、他アプリ、実行時領域で分け合う設計になります。この8GBは余裕の概算で、実際の利用可能量は起動後の表示で確定します。ROCm対応と16GBという仕様を、作業の同時実行条件まで落とし込むと運用しやすくなります。
llama.cppのHIPビルドでは、W7700に対応するGPUターゲットgfx1101を指定できます。AMDのROCm一覧にあるgfx1101とビルド対象を合わせると、使用するGPU向けの実行ファイルを作れます。既製バイナリを使う場合は、配布元が含めたGPUターゲットを確認して選びます。
ローカルLLMでの結論
ROCmのW7700対応はAMDの一覧で確認でき、llama.cppにはHIP経路があります。16GBへ収まる量子化モデルを選び、キャッシュを含む実使用量を見ながら設定すると、ローカル推論の構成が具体化します。導入前にOSとROCm版を確定させ、制作アプリとの併用を考えるならメモリを分けて使いましょう。