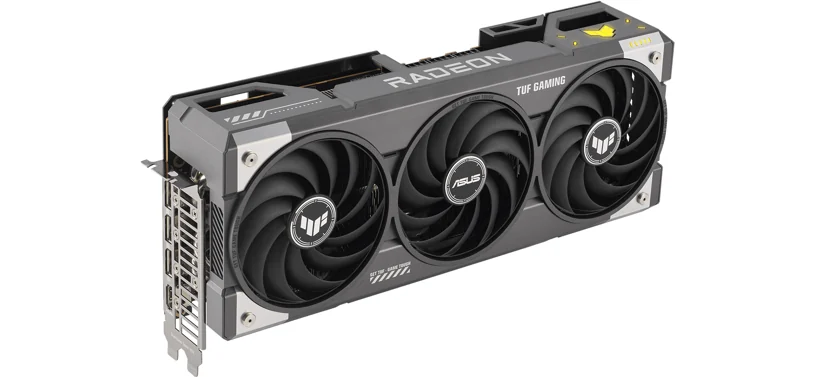
16GBのRX 9070 XTを2枚使うと、モデルの層を二つのGPUへ分けて大型LLMを実行できます。各GPUのVRAMは独立しており、アプリによる分割が必要です。モデルを複数GPUへ分けるソフトウェアと、2枚を安定して動かせるPC構成が必要です。大型モデルのために増設する前に、何が変わるかを整理します。
2枚で増えるのは分割して使える容量
AMDの仕様ではRX 9070 XTは1枚16GBです。2枚なら物理的なVRAMの合計は32GBですが、各GPUは独立したメモリを持ちます。モデルを両方へ載せるには、推論アプリが層や重みを分割して配置する必要があります。1枚分より大きいモデルが使えるようになっても、単一のGPUに32GBの空き領域が生まれるわけではありません。
たとえばQwen公式の32B・Q4_K_Mファイルは19.8GBです。1枚の16GBには重みの時点で収まりません。2枚の計32GBなら分割を検討できますが、両方のVRAMにKVキャッシュや作業領域も必要です。実際にはGPUごとの空き容量が上限になるため、モデルを載せた後の各GPUのメモリ使用量を確認します。
llama.cppの分割方式
llama.cppのサーバー資料には、--split-modeにnone、layer、row、tensorの方式があり、標準は層を分けるlayerです。--tensor-splitではGPUごとの割り当て比率を指定できます。まず各GPUを認識できるか確認し、標準の層分割で小さいモデルを動かしてから、1枚には収まらないモデルへ進むと、ハードウェアの問題と分散設定の問題を分けられます。
層分割では各GPUが担当する層を順番に処理します。したがって、2枚にしても単一リクエストの生成速度が単純に2倍になるわけではありません。rowやtensorは重みの分け方が異なり、GPU間の通信量も変わります。大きいモデルを収めたいのか、複数の利用者へ同時に応答したいのかで選ぶ方式が変わるため、用途に近い条件で測ります。
| 目的 | まず確認する点 |
|---|---|
| 16GBを超えるモデルのGPU配置 | 両GPUへの層分割と空きVRAM |
| 同時リクエストを増やす | アプリの並列処理方式と各GPUの負荷 |
| 速度の改善 | GPU間通信、分割方式、実測トークン速度 |
| 安定運用 | スロット配置、電源、冷却、ドライバー |
マザーボードと電源の条件
AMDのRadeon複数GPU向け資料はLinux構成を対象に、PCIeスロットの接続経路やレーン幅、電源容量を確認するよう案内しています。特にCPU直結のスロットを使い、チップセット側に接続されたスロットを避ける推奨が記されています。マザーボードに長いスロットが二つ見えても、電気的なレーン数と接続先が同じとは限りません。購入前にマザーボードの仕様書で2枚挿し時の構成を確認します。
RX 9070 XTの標準的なボード電力はAMD仕様で304Wです。2枚ならGPUだけで計算上608Wになり、CPU、ストレージ、ファンなどの分がさらに必要です。2枚構成の電源容量は、各カードの実際の電力、CPUなどの消費分、電源コネクターを基に見積もります。厚いクーラーのカードは隣のスロットをふさぐため、ケース内の間隔と吸気経路も確認してください。
動作確認の順番
最初は1枚だけでROCmまたはVulkan版llama.cppを動かし、モデルとGPU名を記録します。2枚目を追加したら、AMDのllama.cpp手順にあるデバイス一覧で両方が見えるかを確認します。OSから2枚が見えていても、使うバックエンドに両方が表示されるとは限りません。次に小さいGGUFで分割のログを見て、各GPUに実際にバッファが確保されたかを確かめます。
大きいモデルへ進んだ後は、GPUごとのVRAM使用量、CPU側に残った層、生成速度を残します。クラッシュする場合はモデルを小さくし、1枚ずつの実行に戻すと、電源やスロットの問題とVRAM不足を切り分けやすくなります。AMDの古い複数GPU資料は特定ROCm版に基づくので、版固有のドライバー番号ではなく構成上の確認項目を参考にします。
2枚の使い方には、一つの大きなモデルを分割する方法と、各GPUで別々のモデルや処理を動かす方法があります。後者は各モデルが16GB以内ならGPU間で重みを渡す必要がなく、同時に別の仕事を進めたい用途に向きます。対して一つの大きなモデルを動かす用途では、両GPUへの割り当てとGPU間通信を含む実測が判断材料になります。
まとめ
RX 9070 XTを2枚にするとVRAMの物理的な合計は32GBですが、大きなLLMの実行にはアプリ側の分割が必要です。増設前にPCIe配線、GPUだけで計608Wとなる電力、冷却を確認し、増設後はGPUごとのモデル配置をログで見て判断します。